Vergleich
Live-Ausgabe der echten Render-Engine — ändere die Einstellungen und sie aktualisiert sich sofort.
Modell-Benchmark
gestaltete motion-karten
KI-Modelle liefern sich auf einem Benchmark ein Rennen als leuchtende Balken oder Säulen, die sich überholen, dann sortieren sie sich nach Rang neu und der Sieger erhält eine Krone, dein Modell bleibt durchgehend hervorgehoben.
Ideal für: Modell-Launches, Eval-Ergebnisse und „Wir schlagen sie“-Vergleiche.
Einstellungen
Schrift
Theme
Größe
Stimmung
Formate, die die Bildprüfung bestanden haben
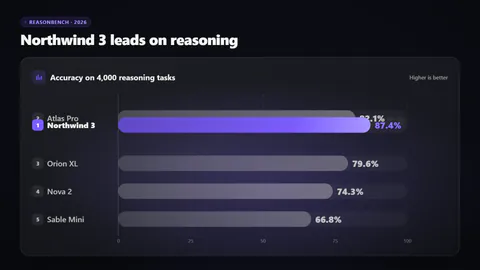
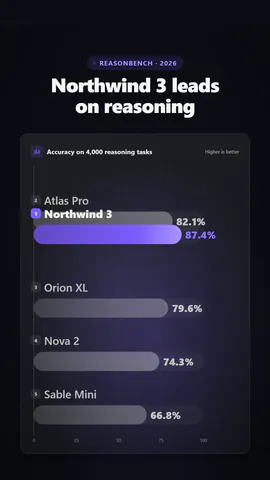
1:1
Was du schreibst
headlineHeadline above the chart (≤52)· PflichtmetricWhat the scores measure, shown on the chart (≤36)· PflichtmodelsThe models and their scores, in the order they line up before the race· PflichtoursName of your model, highlighted throughout (or empty to highlight the winner only) (≤18)· PflichtkickerSmall line above the headline, or empty to hide (≤28)suffixUnit after each score (≤4)decimalsDecimal places shown (≤2)chartHorizontal bars racing right, or columns racing upfinishAfter the race the bars re-sort into rank order, or stay where they started
Eine Code-Vorlage: in jedem Tarif kostenlos, ohne KI-Credits.
In einem Film verwenden
Was du ändern kannst:
rushie.props.headlinerushie.props.metricrushie.props.modelsrushie.props.oursrushie.props (others)Für Entwickler (MCP und JSON)
Das ist genau die Szene für create_animation (MCP): Struktur behalten, Worte ändern und den Sprechertext schreiben — die Stimme bestimmt, wie lange die Szene dauert. Mit set_data in update_storyboard einfügen, um einen fertigen Film zu ändern.
{
  "visual": "rushie",
  "heading": "Model benchmark",
  "narration": "Write the sentence the voice says over this scene; its length is the scene's.",
  "data": {
    "rushie": {
      "template": "model-benchmark",
      "props": {
        "kicker": "ReasonBench · 2026",
        "headline": "Northwind 3 leads on reasoning",
        "metric": "Accuracy on 4,000 reasoning tasks",
        "suffix": "%",
        "decimals": 1,
        "models": [
          {
            "name": "Atlas Pro",
            "score": 82.1
          },
          {
            "name": "Northwind 3",
            "score": 87.4
          },
          {
            "name": "Orion XL",
            "score": 79.6
          },
          {
            "name": "Nova 2",
            "score": 74.3
          },
          {
            "name": "Sable Mini",
            "score": 66.8
          }
        ],
        "ours": "Northwind 3",
        "chart": "bars",
        "finish": "rank"
      }
    }
  }
}